
2026年のAIサーバー用プリント基板の需要
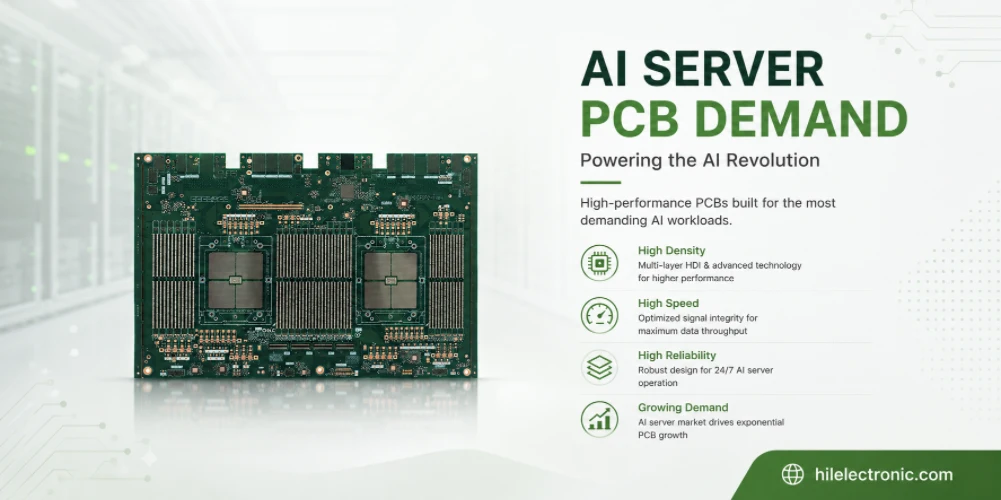
AIサーバーハードウェアは、2026年にPCB業界を再構築する最大の原動力となる。変化は漸進的なものではなく、PCBの構成要素の価値、材料グレード、層数、サプライヤーの集中度において、段階的な変化である。モルガン・スタンレーが2026年5月22日に発表したNVIDIAの次期Vera Rubin VR200 NVL72ラックの部品表(BOM)の分解によると、ラックあたりのPCB構成要素の価値は、GB300の約35,100ドルからVR200の約116,700ドルへと、世代間で233%増加した。同じレポートでは、MLCCの構成要素の価値が182%、ABF基板が82%増加し、ラック全体の平均販売価格(ASP)は約780万ドルとなり、現在のGB300ラックのほぼ2倍になると示されている。
このガイドでは、Rubinプラットフォーム内部の技術的および材料的な変更点、それを構築するサプライヤーエコシステム、そして他のすべての関係者へのPCB材料配分への波及効果について解説します。価格設定に関する背景情報は「PCB価格上昇分析」、基礎となる材料経済性については「PCB原材料コストガイド」、供給集中度については「PCB材料不足分析」、そして設計および調達における対応策については「PCBコスト削減ガイド」に記載されています。
1. 見出しの数字:1ラックあたり35,100ドル → 116,700ドル
モルガン・スタンレーのアナリスト、ハワード・カオ氏が2026年5月22日に発表した、NVIDIA Vera Rubin VR200 NVL72ラックのボトムアップBOM(部品表)分析は、2026年のAIサーバーPCB経済性に関する主要な数値を明らかにした。すべての下流部品の中で、PCB含有量の価値が前年比で最大の増加を記録した。
| 成分 | GB300コンテンツバリュー | VR200コンテンツ価値 | 前日比 |
|---|---|---|---|
| ラックあたりのPCB含有量 | 〜$ 35,100 | 〜$ 116,700 | + 233% |
| MLCC(積層セラミックコンデンサ) | 〜$ 1,530 | 〜$ 4,320 | + 182% |
| ABF基質 | - | - | + 82% |
| メモリ(HBM + SOCAMM) | 〜$ 370,000 | 〜$ 2,000,000 | + 435% |
| GPUシリコン | 〜$ 2,520,000 | 〜$ 3,960,000 | + 57% |
| 電源 | - | - | + 32% |
| 液体冷却 | - | - | + 12% |
ロイター通信が入手した業界分解データによると、2026年の一般電子機器向け多層基板の価格は1平方メートルあたり約204ドルとなる一方、ハイエンドAIサーバー基板は1平方メートルあたり約1,970ドルと、標準価格の約10倍に達する。この価格差は材料の違いによるもので、層数、CCLグレード、銅箔プロファイル、ガラスクロスグレード、表面仕上げなど、いずれもそれぞれのカテゴリーで最高級レベルに位置している。
AIサーバーのPCB含有量が世代間で233%増加しているのはなぜか?
Rubinは2つの効果を組み合わせている。まず、既存のPCBタイプはより大型で複雑化している。Rubinのコンピューティングボードは、GB300の22層HDI PCBから26層基板にアップグレードされ、材料グレードもM7からM8に向上している。次に、RubinはGB300には存在しなかった全く新しいPCBモジュールを導入している。これには、ミッドプレーンPCB(ラックあたり18ユニット、1ユニットあたり1,500ドル)とConnectXモジュールPCB(ラックあたり72ユニット、1ユニットあたり270ドル)が含まれる。これら2つの新タイプだけでも、ラックあたり約46,400ドルのPCBコンテンツ価値の増加に貢献している。
2. なぜODMからRubin VR200 NVL72が7.8万ドルもするのか
モルガン・スタンレーの分析によると、ODMからのRubin VR200 NVL72ラック一式は約780万ドルと推定され、Lenovo、Asustek、Giga-Byte、DellなどのOEMチャネル経由の場合はさらに高額になる。これは、現在のGB300ラックの400万ドル弱のほぼ2倍である。この値上げは、部品表全体にわたって広範囲に及んでいる。
- メモリが最大の要因である。 メモリシェアはGB200 NVL72 BOMの5~10%から VR200の部品表の25~30%メモリの絶対コストは、約370,000万ドル(GB300)から約200万ドル(VR2)へと上昇した。これは、HBM含有量の増加と、メモリ市場全体の価格改定の両方によってもたらされた435%の増加である。
- GPUシリコンのドル建て価格は57%上昇した。 —ラックあたり約2.52万ドルから約3.96万ドルまで—しかし、GPUが部品表全体の割合を占める 落ちた メモリやその他の部品の成長が速かったため、約65%から約51%に減少した。
- PCB含有量が233%急増 Rubin社が導入した、層数の増加、プレミアムCCLグレード、および全く新しいPCBモジュール(ミッドプレーン、ConnectX)を背景に、ラックあたりの価格は約35,100ドルから約116,700ドルに上昇した。
- MLCCの含有量は182%増加した。 ラック1台あたり約1,530ドルから約4,320ドル。VR200ラック1台あたり、現在約 600,000万個の多層セラミックコンデンサGB300の件数を30%以上上回る。
- ABF基質の価値は82%増加した。これは、Rubin GPUに必要なより大きな基板面積と、CCLにも影響を与えているのと同じTガラスに起因するコスト圧力の両方を反映している。
AI以外の購入者にとって、これは何を意味するのでしょうか。1つのRubinラックに含まれる116,700ドル相当のPCBコンテンツは、AI以外のワークロードと比較して、1ドルあたりの密度が劇的に高くなっています。CCLメーカー(Kingboard、Shengyi、EMC、TUC、Doosan、MGC)、銅箔メーカー(三井金属、古河電気工業、JX日本)、ガラスクロスメーカー(日東紡)、表面処理化学メーカー(アトテック、ウエムラ)はそれぞれ、ハイパースケールAI購入者が、標準的な産業用または消費者向けPCB需要よりも優先して注文を出しているのを目にしています。割り当てによる伝播は、2026年に他のすべての業界がより多くの費用を支払うことになる理由の1つです(第7章で説明します)。
3. CCLグレードラダー:M6 → M7 → M8 → M9 Q-Glass → M10
AI基板のコスト上昇の技術的な理由は、CCLグレードの上昇にあります。グレードが上がるごとに、樹脂の化学組成、銅箔の形状、ガラスクロスのグレードが同時に変化するため、材料費は増加するのではなく、増加します。H100/GB200からRubin Ultraまでの進化は、約3世代にわたって5つのMグレードに及びます。
| NVIDIAプラットフォーム | PCB層 | CCLグレード | ガラスクロス | 翼型プロファイル |
|---|---|---|---|---|
| H100(ホッパー、2022年~2024年) | 〜22 | M6 / メグトロン6 | NEガラス | VLP |
| GB200(ブラックウェル、2024年) | 〜22 | M7 / メグトロン7クラス | NEガラス/Tガラス | HVLP |
| GB300(ブラックウェル・ウルトラ、2025年) | 22-34 | M7 / メグトロン7 | Tグラス | HVLP / HVLP4 |
| VR200(ルービン・コンピューティング、2026年~2027年) | 26(コンピュータボード);ミッドプレーン最大44 | M8 / Qガラス | Tガラス/Qガラス | HVLP4 |
| ルビンLPX | 〜52 | M9 Qガラス | Qガラス | HVLP4 / HVLP5 |
| ルービン・ウルトラ(カイバー、2027年以降) | ~78+ | M9+ Q-glass / M10(資格取得時) | Qガラス | HVLP5 |
この段階を上がるにつれてコストが劇的に上昇します。業界データによると、M6 CCL は標準 FR-4 の約 3~5 倍、M7 は 6~9 倍、M8 は 10~15 倍、M9 Q-glass は 15~20 倍のコストがかかります。現在認定中の次世代 M10 グレード (Df <0.002) は、この段階をさらに延長します。2026 年 3 月 13 日、アナリストのミンチー・クオ氏は、NVIDIA がWus Printed Circuitと提携して、次世代 HVLP5 銅箔と Q-glass クロスを使用したテストボードで 448G+ シグナリング用の M10 CCL をテストしていることを確認しました。
Q-glassとは何か、そしてなぜAIにとって重要なのか?
Q-glassは、高純度石英繊維(約99.99% SiO₂)から作られたガラス繊維布です。誘電率Dkは約3.0、誘電正接Dfは約0.0007で、いずれもNE-glassやT-glassよりも大幅に低くなっています。224Gおよび448Gのデータレートでは、信号経路全体の損失許容範囲が非常に狭いため、ガラス繊維の織りムラによる残留損失が支配的な要因となります。Q-glassは、補強材自体の体積誘電率を低下させることで、この損失を低減します。Q-glassの主要サプライヤーは、信越化学工業、旭化成、Glotech、Feilihua、Taishan Fiberglass、Hong Hoです。
4. レイヤー数の増加:22レイヤーから26レイヤー、44レイヤー、78レイヤーへ
NVIDIAのAIコンピューティングボードにおけるPCB層数の進歩は、過去3世代にわたって加速している。
- H100コンピューティングボード: 約22層。
- GB300コンピューティングボード: 構成によって22~34層。
- Rubin VR200 コンピューティングボード: 26層 (モルガン・スタンレーの分解調査によると)GB300の22層HDIからアップグレードされている。
- Rubin VR200ミッドプレーンPCB: 到達 44層 ラック内で最も高速な相互接続プレーン用。
- ルービンLPX: 約 M9 Qガラスに52層積層.
- ルービン・ウルトラ/カイバー: 約 78以上のレイヤー.
プリント基板に層を追加するごとに、CCLコア、プリプレグ、積層工程、穴あけ、めっき、位置合わせリスクが加わるため、製造コストは約20~30%増加します。22層から44層に倍増すると、積層工程の回数増加、穴のアスペクト比の難しさ、位置合わせ公差の蓄積により、コストは倍増どころか、数倍にもなります。Qガラス基板上に78層まで設計が進むと、製造工程のあらゆる段階が、現在の設備で対応できる限界に達します。
ミッドプレーンにこれほど多くの層が必要な理由→ Rubin VR200 のミッドプレーン PCB は、演算ボード間に配置され、NVL72 ラック内の 72 個の GPU すべてを統合された演算ファブリックに接続します。この基板は、すべての演算ボード間で高速信号を伝送しますが、途中に再ドライバ チップを配置する余地はありません。層数は、信号レート チャネル数に、バックプレーン全体にわたって信号の完全性を維持するために必要な厳密なインピーダンスとクロストークの制約を乗じた値によって決まります。フル ラック規模でチャネル品質を維持するには、Q-glass 上に 44 層が必要です。
5. ミッドプレーン基板とConnectXモジュール ― 2種類の新しい基板タイプ
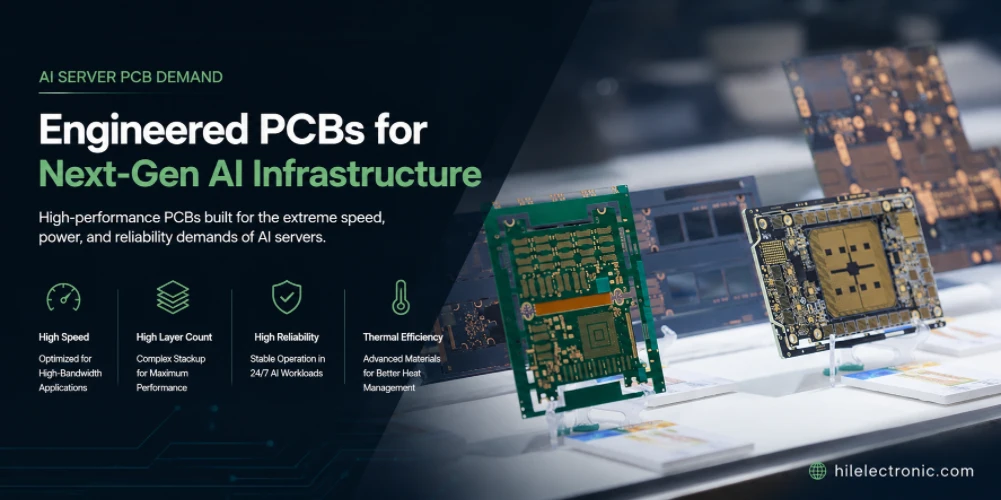
ルービンはGB300にはなかった2種類のプリント基板を導入しており、モルガン・スタンレーの部品表の分解によると、それらだけでラック1台あたり約46,400ドル相当の新しいプリント基板の価値を生み出している。
- ミッドプレーン基板。 ラックあたり18ユニット、単価は約1,500ドル。ミッドプレーンは、NVL72ラック全体にわたってコンピューティングボードを統合NVLinkファブリックに接続する巨大な相互接続PCBです。Qガラス誘電体を使用した層数は44層に達し、長いスパンにわたって224Gチャネルの整合性を維持するためにHVLP4またはHVLP5銅箔が必要です。ABFおよびBT基板メーカーは、これほど大きな基板を容易に製造することはできません。これはPCBの領域です。
- ConnectXモジュール基板。 ラックあたり72ユニット、単価は約270ドル。各ConnectX-8モジュールは、コンピューティングボードのドーターカードとして搭載され、ラックレベルネットワーク用のNICを提供します。ConnectX基板自体は、M7またはM8 CCL基板上にHVLPフォイルと厳密なインピーダンス制御を施した小型のHDIボードです。
これらの新しいPCBタイプはいずれも、プレミアムCCLグレード、プレミアム銅箔プロファイル、および特殊ガラスクロスを必要としますが、これらはすべて下記のセクション7で既に制約されているカテゴリーです。その結果、NVIDIA Rubinは、5G基地局、車載レーダー、およびハイエンドネットワークPCBの顧客も依存している、同じ希少な材料グレードに対する需要を大幅に増加させたことになります。
新しいミッドプレーンPCBは、材料調達において業界の他社製品とどのように競合するのか?
NVIDIAは直接競合する。ミッドプレーンには、次世代5Gミリ波PCBに必要な日東紡、信越化学工業、旭化成が供給するQガラスクロスが使用されている。レーダーや高速ネットワークボードに必要な三井金属のHVLP4/HVLP5銅箔も使用されている。斗山、パナソニック、レゾナック、盛義のM8/M9 CCLも使用されている。NVIDIAのルービン割り当ては、あらゆる層で最先端の材料生産能力を吸収している。
6.プリント基板の調達と製造に関する考慮事項
AIサーバープログラムは、信号品質、電力供給、層間位置合わせ、およびプロセス制御に対して非常に高い要求を課します。最適な製造ルートは、承認された積層構造、チャネル損失バジェット、インピーダンステーブル、ビア構造、銅配線、BGAピッチ、および検査要件によって決まります。
- 生産開始前に、低損失ラミネート材の入手可能性と承認済みの代替品に関する規則を確認してください。
- 製造パッケージと連携して、制御インピーダンス目標、表面粗さ要件、およびクーポン戦略を確認してください。
- DFM(設計製造性)の段階で、シーケンシャルラミネーション、ビア充填、バックドリル加工、および高層数における位置合わせを評価する。
- 基板がPCBAとして供給される場合は、製造、部品調達、および組み立てに関する要件を調整してください。
Highleapは、高速PCB製造に関する見積もり前に、積層構造、インピーダンスデータ、図面、テスト要件などを含む製造パッケージをレビューできます。特別なプロセス要件を持つプロジェクトについては、試作品および量産の両方について評価可能です。
7. AIの需要が他の全員から資材配分を引き出す方法
AI需要が材料サプライチェーン全体に波及していくことは、AI関連以外の購入者にとって2026年のPCB業界における最も重要な出来事となるだろう。ハイパースケールAIの顧客(OpenAI、Google、Microsoft、Amazon、Oracle、Meta、xAI、その他の大規模データセンター事業者向けにRubin VR200ラックを構築している企業)は、事実上、あらゆる最先端材料メーカーの生産能力の大部分を事前に確保している。
- 三井金属 マイクロ薄銅箔 ― 大手高級HVLPフォイルメーカーにおいて、2026年の受注数が設備稼働能力を上回った。
- 日東紡TガラスクロスとQガラスクロス ―受注残は翌年の第2四半期まで持ち越され、価格は約100ドル/kgとなった。
- パナソニック メグトロン 6/7、斗山ハイエンド CCL、MGC/レゾナック CCL ―配分ベースの供給体制に移行した。
- Topoint / Union Tool / Zhongwu マイクロドリル 稼働率が90%を超え、供給が需要を満たせない状態。
- アトテック/ウエムラめっき薬品 ― プレミアムENIGおよび電気めっき能力を、高収益のAIサーバープログラムに割り当て。
実際には、非AIバイヤーがプレミアムCCLまたはHVLPフォイルに対して2024年相当の価格を支払う意思があったとしても、ハイパースケールAIバイヤーが優先的に先物注文を出しているため、必ずしも材料が入手できるとは限らない。韓国関税庁のデータ(2026年3月のCCL輸入価格は1トン当たり20,728ドルに達し、前年比74.5%増、史上初めて1トン当たり20,000ドルを超えた)は、この配分制限を定量的に反映した例の一つである。
ハイパースケーラーが優先的に支払う理由:割当制市場では、最も長期の先行発注契約を結び、1トン当たりの単価が最も高い顧客が優先的に割り当てられます。ハイパースケーラーがM8 CCLで10万枚のRubinコンピューティングボードを発注すると、CCLメーカーは50枚の産業用PCB発注では到底実現できない、割り当て可能な数量と価格決定力を得ることができます。CCLメーカーはハイパースケーラーの先行発注を受け入れ、生産能力を割り当て、残りの生産分が一般のPCB需要に供給されます。
8.AIを利用しない購入者が現在経験していること
AIサーバー用プリント基板を購入しないものの、同じ基礎材料を使用する業界にとって、2026年のサイクルは、リードタイム、価格、材料の入手可能性に好ましくない影響を与えている。
- 通信機器およびネットワーク機器のOEMメーカー。 5G基地局、スイッチ、ルーターは、PPEベースの中損失CCL(メグトロン6クラス)に依存しており、これはAIファミリーが消費するのと同じ材料です。多くの企業は、2024年に購入した同グレードの製品に対して、14~18週間の納期と20~40%の価格上昇に直面しています。
- 5Gインフラプロバイダー。 上流側の供給事象によるPPE樹脂への直接曝露。入手可能な材料でチャネル性能を維持するため、一部の設計は一時的に、より厚い、またはより高グレードの積層構造に再設計されている。
- 自動車用電子機器(特に77GHzレーダー)。 特殊なPTFE/炭化水素積層材(特殊低損失積層材/特殊低損失積層材クラス)も、ハイパースケーラー高周波プログラム向けにAIによって割り当てられています。自動車用レーダーの生産は現在、代替積層材グレードの認定を受けるか、リードタイムの延長を受け入れるかに依存しています。
- 産業用制御機器、電力機器、および民生用電子機器。 標準FR-4は、高級グレードの購入者からの需要の減少分を吸収しており、納期は2~3週間から6~8週間に延びている。AIグレードの材料への接触を完全に避けている購入者でさえ、その影響を実感している。
- 無線周波数/航空宇宙防衛。 特殊PTFE特殊低損失ラミネートタイプの材料は直接的な露出は少ないものの、特殊低損失ラミネート、Taconic、Arlonが高利益率のハイパースケーラープログラムに生産能力を割り当てているため、リードタイムが長くなっています。
AI非搭載のOEM企業は2026年に何ができるのか?
現実的な対応策は、次の 4 つの対策を組み合わせたものです。(1) 基板ごとに 2 つ目の CCL グレードを認定し、製造業者に割り当ての選択肢を提供する。(2) 予測を 12 ~ 26 週間のローリングに延長し、製造業者が需要に応じて CCL の割り当てを確保できるようにする。(3) 過剰仕様がないか設計を監査する。M6 で十分な場合に M7 が指定されている、LP で十分な場合に HVLP 箔が指定されている、OSP で十分な場合に ENIG が指定されている。(4) 重要でない層でプレミアム CCL を削減するハイブリッド スタックアップを使用する。これらについては、コスト削減ガイドで詳しく説明されています。
9. AIサーバー用PCBの需要に関するよくある質問
AIサーバーの需要は、プリント基板製造にどのような影響を与えるのか?
高層数・高インピーダンス基板の需要増加に伴い、特定の低損失ラミネート材、銅箔、および加工能力の供給が逼迫する可能性があります。その影響は、承認された材料、積層構造の複雑さ、数量、および納期によって異なります。
AIサーバー用プリント基板の正確な見積もりには、どのような情報が必要ですか?
PCBAが必要な場合は、ガーバーデータまたはODB++データ、スタックアップ、インピーダンステーブル、製造図面、ドリルデータ、仕上がり厚さ、表面仕上げ、数量、テスト要件、およびアセンブリファイルを提供してください。完全なデータがあれば、材料や製造工程の決定を行う前にエンジニアリングレビューを実施できます。
複雑な高速基板は、試作品および量産規模で製造可能でしょうか?
はい。適切な製造工程は、エンジニアリングレビューの段階で確認されます。複雑な構造の場合、材料の確認、逐次積層、インピーダンス制御、ビア処理、特殊検査、または量産前の試作が必要となる場合があります。
高度なプリント基板の設計チームは、どのようにすれば供給リスクを低減できるでしょうか?
電気予算が許す限り、適切な材料オプションを指定し、スタックアップを早期にリリースし、製造図面で代替品管理を定義し、リスクの高い配線やビア構造を最終決定する前に製造業者を関与させる。
HighleapはいつAIサーバーボードを見直すべきでしょうか?
設計を見積もりに出す前にレビューを行うことは、特に基板に高速チャネル、高密度BGAエスケープ配線、特殊ラミネート、バックドリル、HDI機能、または厳格なトレーサビリティ要件が含まれる場合に最も有効です。

おすすめの投稿

TMM基板製造
目次 TMM PCB製造範囲(RFおよび...)

RT duroid 6002 PCB の見積もりとスタックアップ
このページは、引用とスタックアップ定義タスクを担当しています。

TMM6フィルター基板の製造
目次 電子レンジ用フィルター設計者が使用する理由...

Taconic RF 35 vs RO4350B PCB
目次RF-35とRO4350Bの調達と...
PCBの見積もりを取得する方法
DFM/DFA解析を実施し、結果をレポートとしてお送りします。弊社ウェブサイトから安全にファイルをアップロードできます。お見積もりには以下の情報が必要です。
-
- Gerber、ODB++、または .pcb 仕様。
- 組み立てが必要な場合のBOMリスト
- 数量
- ターンタイム
PCBAサービスをご利用の場合は、BOM(部品表)と具体的な組立指示書をご提出ください。また、DFM/DFA解析により、製造性と組立性を最適化し、スムーズな製造プロセスを実現します。