
面向企业和高性能计算OEM厂商的高性能计算服务器PCB制造
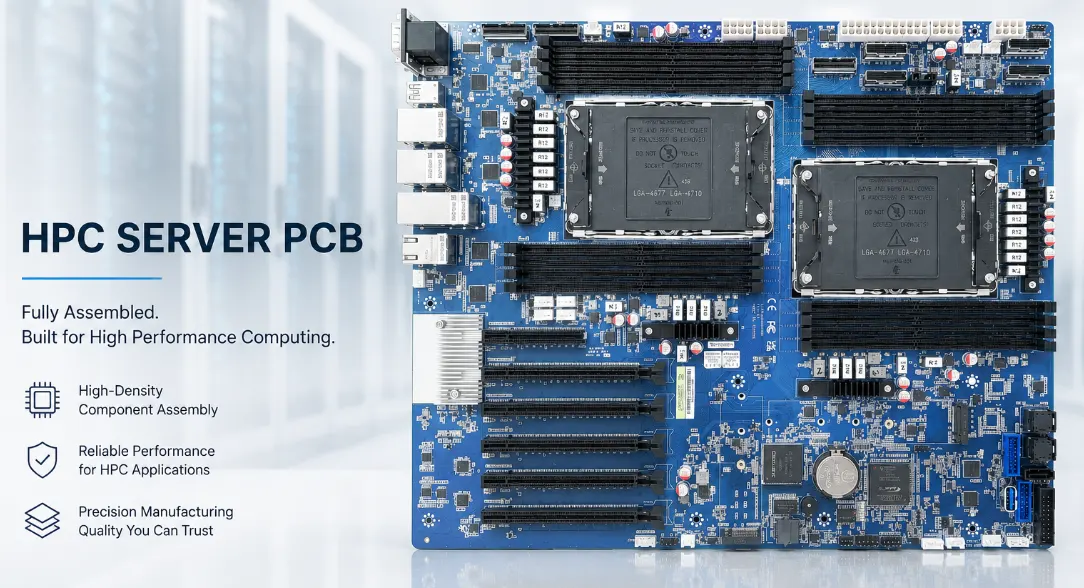
图 1.高性能计算服务器 PCB 制造
Highleap Electronics 根据客户提供的设计图或 Gerber 文件,为高性能计算 OEM 厂商、国家实验室、大学超级计算中心和一级 HPC 系统供应商提供 HPC 服务器 PCB 制造服务。我们根据客户规格制造 PCB,包括计算节点主板(双路和四路 Xeon Max、EPYC HPC、A64FX、NVIDIA Grace/Grace Hopper 载板)、InfiniBand HDR/NDR 和 Slingshot/Omni-Path 互连卡、液冷冷板载板、存储和登录节点板、机架级电源和管理板以及 HBM 主机集成载板。
目录
- 高性能计算设备制造商对PCB制造商的需求(与人工智能训练相比)
- 计算节点主板制造——Xeon Max、EPYC 高性能计算、ARM 高性能计算
- HBM主机和Grace Hopper级载板制造
- InfiniBand HDR/NDR HCA 和互连卡制造
- 直接液冷——冷板支架、CDU 和歧管板
- 内存子系统——DDR5、CXL 和 HBM 供电
- 存储节点、登录节点和集群管理板
- 质量、AVL 资质和长期项目支持
- 在构建高性能计算集群时使用 Highleap
1. 高性能计算OEM厂商对PCB制造商的需求(与人工智能训练相比)
高性能计算 (HPC) 服务器项目和人工智能 (AI) 训练服务器项目乍看之下十分相似——两者都构建高密度计算硬件,采用高带宽互连,都大规模使用液冷技术,都面向少量高价值客户。区别在于项目周期、认证严格程度和生命周期预期。我们的高性能计算 PCB 制造能力涵盖了 AI/HPC 融合架构和传统的 CPU 高密度 HPC 集群。
高性能计算采购周期差异
- 采购时间表: 高性能计算系统合同从 RFP 到系统验收的周期为 2-4 年;人工智能硬件项目周期为 12-18 个月。
- 资格审查的严格性: 国家实验室和大学高性能计算中心通常需要正式的验收测试,包括PCB级验证样品;许多人工智能硬件程序接受超大规模数据中心式的AVL流程,但形式要求较低。
- 客户集中度: 高性能计算 (HPC) 市场高度集中,主要由美国能源部实验室、顶尖大学和世界 500 强企业组成,客户关系往往长达数十年。人工智能 (AI) 硬件市场则更为分散,超大规模数据中心、自主 AI 项目和企业级 AI 采购商都使用众多供应商的产品。
- 可持续性生命周期: 高性能计算系统通常运行7-10年;人工智能训练硬件每2-3年更新一次。
高性能计算工程要求与人工智能训练的要求不同
- CPU主导型架构仍然存在: 虽然 AI/HPC 融合是现实的,但许多 HPC 工作负载(CFD、MD、气候建模)仍然以 CPU 为主导;计算节点有 4-8 个 CPU 插槽,最大 DDR5 通道数。
- 内存容量与带宽平衡: HPC 工作负载通常需要两者兼备——每个节点 4 TB 以上的容量和高带宽并不罕见;CXL 扩展变得越来越重要。
- 向量处理重点: AVX-512、SVE2 和类似的矢量指令集架构 (ISA) 对持续的矢量工作负载提出了特定的路由和供电要求。
- 网络/存储融合: InfiniBand 采用 RDMA 技术,既用于互连又用于存储;使用一个网络而不是单独的计算网络和存储网络。
- 突发缓冲和分层存储: 专用突发缓冲节点,支持高性能 NVMe 和 DAOS/Lustre/GPFS;专用存储载板。
高性能计算采购方面的要求
- 正式的RFP回复: 根据客户的技术和商业要求制定详细的方案。
- 系统验收支持: 样品板和完整的客户验收测试文档。
- 可持续发展承诺: 7-10 年备件供应承诺,并有完善的 EOL 管理记录。
- 审计和可追溯性: 一些国家实验室和国防相关项目需要完整的供应链审计追踪。
- 原产地证明文件: 购买美国产品、购买欧洲产品,以及在适用情况下满足主权供应要求。
2. 计算节点主板制造 — Xeon Max、EPYC 高性能计算、ARM 高性能计算
高性能计算节点主板是每个集群的核心。当前平台采用配备 HBM 显存的 CPU 和加速器-CPU 混合架构;我们为所有平台构建主板。
英特尔至强Max(蓝宝石Rapids HBM)和花岗岩Rapids HPC主板
- Xeon Max: 封装内含 64 GB HBM2e 内存,每个插槽最多支持 8 个 DDR5 通道;功耗和散热密度显著。
- 层数: 通常双路 Xeon Max 主板有 16-22 层——我们的 多层PCB制造 该生产线支持从 12 层到 32 层以上的双控制器配置的 HPC 主板。
- 路由复杂度: 每个插槽 8 个 DDR5 通道 × 2 个插槽 = 16 个 DDR5 通道,此外还有 PCIe Gen5 和插槽间 UPI 链路。
- UPI链路路由: 插槽之间采用 4 链路或 6 链路 UPI;对信号完整性有与 PCIe Gen5 类似的严格要求。
- 供电: 每个插槽 350-400W TDP;VRM 密集布局,低阻抗电源分配。
- 材料: UPI 和 PCIe Gen5 层采用 I-Tera MT40;DDR5 层采用 FR408HR;电源层采用 370HR。
AMD EPYC HPC(热那亚-X、贝加莫、都灵)主板
- EPYC 热那亚-X: 96 个核心,1 GB L3 缓存(3D V-Cache);每个插槽 12 个 DDR5 通道。
- EPYC 都灵: 下一代;每个插槽最多可达 192 个核心。
- 层数: 由于 DDR5 通道数量较多,双路 EPYC HPC 主板通常有 18-24 层。
- Infinity Fabric 插孔间连接: 插座间高密度高速布线;PCB要求与UPI类似。
- PCIe Gen5通道数: 每个插槽 128 条通道 = 每个双插槽系统 256 条通道;即使不考虑 DDR5,布线密度也相当高。
富士通 A64FX 和 ARM HPC 主板
- A64FX: 封装内含 48 个核心和 32 GB HBM2 显存;ARMv8.2-A SVE;由富岳提供的百亿亿次级系统。
- NVIDIA Grace: 72 核 ARM Neoverse V2,配备 480-960 GB LPDDR5X 内存;面向高性能计算、人工智能和数据分析。
- Ampere Altra Max 和 AmpereOne: 通用 ARM 服务器 CPU 在高性能计算领域应用日益广泛。
- 层数和复杂度: 与 x86 HPC 主板类似;配备 LPDDR5X 的 Grace 主板由于采用焊接式内存而不是 DIMM 插槽,因此具有独特的布线方式。
四路和八路胖节点主板
- 用例: 内存数据库、大型共享内存模拟、不适合分布式内存的专用高性能计算工作负载。
- 层数: 由于插座互连的复杂性,共22-28层。
- 插孔间织物: UPI 或 Infinity Fabric 在 4 个插槽以上扩展性较差;一些四插槽设计采用环形拓扑结构,另一些则采用交换式拓扑结构。
- 内存容量: 每个节点通常有 8-16 TB 的存储空间;电路板上有相当大的 DIMM 内存空间。
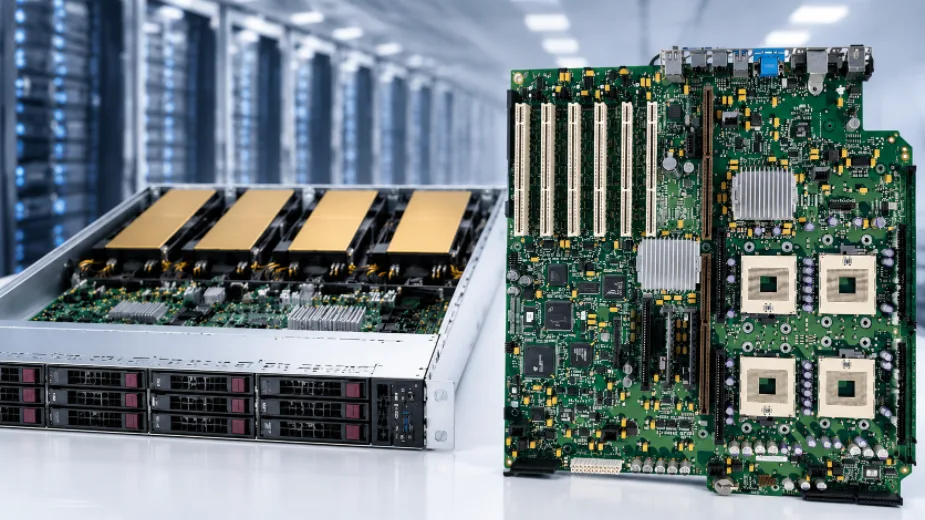
图 2.高性能计算服务器 PCB
3. HBM主机和Grace Hopper级载板制造
搭载 HBM 显存的 CPU 是这一代高性能计算 (HPC) 处理器架构的标志性架构之一。无论 HBM 是封装在芯片内部(例如 Xeon Max、A64FX),还是通过芯片间互连连接(例如 Grace Hopper Superchip),主机 PCB 在供电、散热和信号传输方面都有着与非 HBM 主板不同的特定要求。
格蕾丝·霍珀超级芯片载体制造
- 结 构: NVIDIA Grace ARM CPU + Hopper GPU 通过 NVLink C2C(芯片到芯片)绑定;CPU 和 GPU 之间 900 GB/s 相干 NVLink。
- 载板结构: 通常为 18-24 层。
- NVLink C2C 路由: 同一载体上的两个芯片之间采用短、高速相干结构;对电路板上的信号完整性要求最高。
- HBM3(在料斗模具上): 虽然没有在 PCB 上布线,但通过向 Hopper 芯片封装提供充足的电源来支持。
- LPDDR5X(Grace 附加): 焊接在 Grace 芯片附近的载体上;LPDDR5X 高速数据速率布线。
- 材料: Tachyon 100G 或 Megtron 7 用于 NVLink C2C;I-Tera MT40 用于 PCIe Gen5 主机;FR408HR 用于 LPDDR5X。
为配备 HBM 的 CPU 提供电源
- 电流: 配备 HBM 的 CPU 在持续矢量工作负载下消耗 400-500W TDP;核心轨上的持续电流为 500-800A。
- VRM放置位置: 大电流 VRM,负载点位于 CPU 封装下方或附近。
- 平面铜: 核心电源层使用 2-3 盎司铜;某些设计在特定的高电流轨上使用 4 盎司铜。
- 去耦电容密度: 每个插座有数百个电容器,分布在整个供电层级中。
- 平面阻抗: 在设计阶段通过电源完整性仿真验证了低阻抗平面设计;PCB 制造必须精确地达到建模的叠层结构。
HBM-主机封装制造注意事项
采用 HBM 显存的 CPU 封装体积庞大且机械重量沉重。其下方的 PCB 必须从机械(冷板夹紧力或插槽固定力)、散热(传递来自封装背面和 VRM 的热量)和供电(通过封装下方的电源过孔输送数百安培的电流)三个方面支撑封装。对于 HBM 主机 PCB 的制造而言,工具孔公差、机械加固结构以及封装下方的过孔阵列设计都至关重要,而这些对于传统 CPU 主板则无关紧要。
4. InfiniBand HDR/NDR HCA 和互连卡制造
高性能计算 (HPC) 互连对系统级性能的驱动力远超其他任何单一组件。InfiniBand 凭借其 HDR (200 Gbps) 和 NDR (400 Gbps) 产品在高端 HPC 市场占据主导地位;HPE Slingshot(原 Cray)和 Intel Omni-Path 则是某些 Top500 系统中的替代方案。
InfiniBand HDR HCA载板制造
- 适配器芯片: NVIDIA ConnectX-6 (HDR) 或 ConnectX-7 (HDR/NDR)。
- 端口数量: 通常为单端口或双端口HDR卡。
- PCIe Gen4 主机接口: 16 通道 Gen4 到主机 CPU;一些 Gen5 主机使用相同的卡。
- 网络接口: 用于HDR布线的QSFP56连接器。
- 层数: 双端口 HDR HCA 上有 14-18 层。
- 材料: I-Tera MT40 用于 PCIe 和网络路由;370HR 用于电源和接地。
InfiniBand NDR HCA载板制造
- 适配器芯片: NVIDIA ConnectX-7 NDR,具备 400 Gbps 传输能力。
- PCIe Gen5 主机接口: 16 条 Gen5 车道; 背钻 主机侧过孔必须这样做。
- 网络接口: 用于 NDR 布线的 OSFP 连接器。
- 层数: 由于高速布线密度较高,所以需要 16-20 层。
- 材料: 在关键的 NDR 网络和 Gen5 主机信号层上使用 Tachyon 100G 或 Megtron 7。
- 有偿推广: PCIe边缘连接器和OSFP笼的精确阻抗匹配发射。
HPE Slingshot 和 Omni-Path HCA 制造
- 弹弓: 在 Cray/HPE EX 级系统(Frontier、El Capitan)上实现 200 Gbps 互连;物理层兼容以太网,并具有 HPC 专用拥塞控制。
- Omni-Path: 英特尔的 100 Gbps 互连技术;虽然是老技术,但仍在特定集群类别中生产使用。
- HCA卡构造: 与 InfiniBand HCA 类似;PCIe Gen4 主机,定制网络接口。
InfiniBand交换机线路卡制造
- NVIDIA Quantum-2 NDR 开关: 每个交换芯片支持 64 个 400G 端口或 32 个 800G 端口。
- 交换机线路卡层数: 28-32层。
- 布线密度: 从交换机ASIC到OSFP笼,数百个差分对。
- 材料: 100G超光速粒子贯穿整个信号层。
- 供电: 每个开关芯片800-1200W;高密度VRM设计和厚实的电源层铜。
5. 直接液冷——冷板支架、CDU 和歧管板
现代高性能计算系统主要采用CPU插槽直接液冷。国家实验室的百亿亿次级系统更进一步,采用温水冷却,实现了全年无休的自然冷却。液冷高性能计算的PCB设计已经成熟,但仍然需要精细的工程设计和制造。
冷板载板制造
- 机械对准: 用于冷板对准的精密加工孔,位置公差为±0.10毫米。
- 板材平整度: CPU 占空比 ±0.15 毫米,以确保冷板接触均匀。
- 组件高度限制: 冷板下方的元件深度不能超过冷板的减压深度;与冷板供应商进行严格的DFM协调。
- 安装加固: 板载支架或加强筋支撑夹紧力;PCB 设计考虑支架接口。
CDU(冷却液分配单元)控制板制造
- 功能: 管理机架级冷却液流量、温度设定点、泵控制、泄漏检测和报警。
- 结 构: 通常采用嵌入式 ARM SBC,具有工业 I/O(4-20 mA 流量传感器、RTD 温度输入、阀门驱动器)。
- 层数: 6-8层;混合模拟/数字电路,并具有适当的隔离。
- 材料: 用于工业可靠性的高Tg FR4(Isola 370HR)。
- IPC等级: 故障模式关键部件的3级验收标准。
歧管传感器板制造
- 分布式感知: 多个歧管点的流量、温度、压力。
- 小尺寸格式: 通常为 60 × 40 毫米,带 M12 工业连接器。
- 保形涂层: AR 或 UR 涂层是防潮的标准涂层。
- 无铅回流焊: 标准SAC305工艺与所有指定材料兼容。
泄漏检测和滴水盘板
- 电容式泄漏传感器: 分布在冷板下方和潜在泄漏点。
- 滴水盘电子元件: 排水监测,并向机架 BMC 发出警报信号。
- 可靠性: 误报率非常严重(误报会导致计算机关闭);漏报率也很严重(漏报会导致设备损坏)。
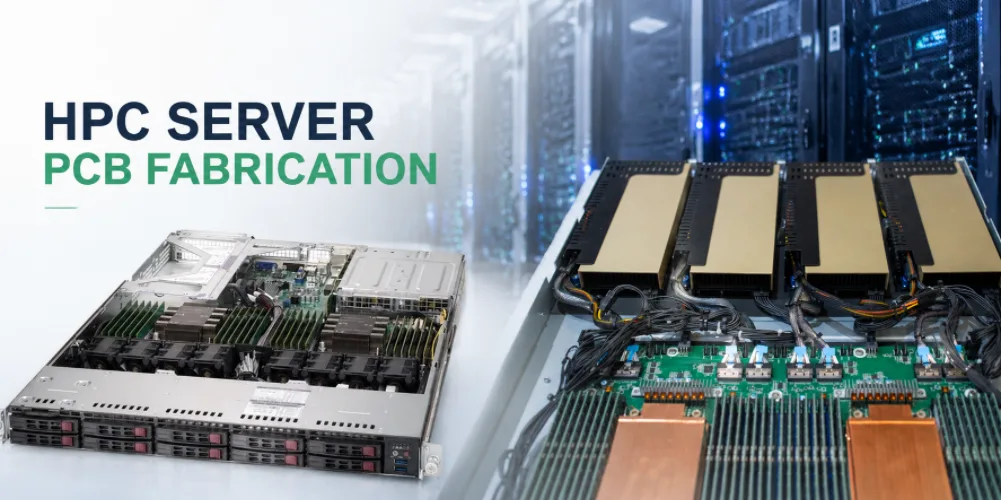
图 3.存储服务器 PCB 制造商
6. 内存子系统——DDR5、CXL 和 HBM 供电
HPC 工作负载内存需求决定了 PCB 制造工艺中 DDR5 布线、CXL 内存扩展和载板上 HBM 供电的具体选择。
HPC主板的DDR5布线
- 频道数量: 每个插槽 8 个通道(Intel Xeon Max),每个插槽 12 个通道(AMD Genoa-X)。
- 数据速率: 根据平台不同,内存容量从 DDR5-4800 到 DDR5-6400 不等;每一代都在提升。
- 阻抗设置: 40Ω 单端 ±10% 标准;可达到 ±7%。
- 长度匹配: 字节内误差±2 mil;字节间误差随速度而变化。
- 材料选择: FR408HR 适用于短信道;I-Tera MT40 适用于长信道或更高数据速率;370HR 适用于短距离低速率运行。
- 玻璃纤维: 1080 或 2113 玻璃用于高速 DDR5 信号层。
CXL存储器扩展制造
- CXL 2.0附件: PCIe Gen5 PHY;CXL 内存扩展器通过 PCIe 插槽或专用 CXL 连接器连接。
- 高性能计算应用案例: 内存池化可将每个节点的有效内存扩展到 DIMM 容量之外;对于内存分析、大型网格模拟和 AI/HPC 融合工作负载尤其有价值。
- 制造要求: 第五代差分对阻抗和背面钻孔精度。
- 背板构建: CXL 交换技术为高性能计算系统引入了一种新型的背板和交换机板。
在配备 HBM 的 CPU 载体上实现 HBM 供电
虽然 Xeon Max、A64FX 和 Hopper GPU 产品中 HBM 堆叠已集成在封装内,但主机 PCB 必须提供足够的电流来支持主机芯片和 HBM 堆叠。电源层必须能够处理超出传统 CPU 主板设计假设的电流,并在封装下方采用适当的密集过孔布局以最大限度地减少电压降。设计阶段的电源完整性仿真至关重要;PCB 制造必须达到仿真堆叠的精度,介质层厚度公差控制在 ±5% 以内,以确保性能符合模型预期;此外,在整个制造过程中,所有关键的 Gen5 差分对都需要进行阻抗控制。
7. 存储节点、登录节点和集群管理板
高性能计算集群除了计算节点外,还包含多种类型的板卡。存储、登录和管理基础设施板卡虽然体积较小,但对系统可靠性至关重要。
存储节点制造
- Lustre/GPFS 存储服务器: 采用双路 Xeon 或 EPYC 主板,配备高密度 NVMe 和 SAS 存储背板。
- NVMe存储背板: U.2/U.3 热插拔背板,支持 PCIe Gen4/Gen5 连接到存储控制器。
- DAOS存储节点: 面向下一代高性能计算存储层的持久内存存储;专用 NVMe 背板和 PMEM 模块集成。
- 突发缓冲节点: 高密度 NVMe 服务器用作计算节点和并行文件系统之间的 I/O 加速层。
登录节点和管理服务器制造
- 登录节点主板: 通用服务器主板(单路或双路),支持用户 shell 和作业提交;对性能要求不高,但对可靠性要求很高。
- 管理服务器: 集群调度程序(Slurm、LSF、PBS Pro)主机;用于计费和监控的数据库服务器。
- 标准服务器PCB设计规范: 最多采用中等损耗材料;成本优化的叠层结构。
机架顶部和管理型交换机
- 1 GbE 管理交换机: 独立的管理以太网网络,与数据结构隔离。
- 10/25 GbE 业务网络交换机: 用于存储访问和管理流量。
- 带外管理: 串行控制台集中器、IPMI/Redfish 网关。
机架级电源和基础设施
- 48V电源架板: 集中式配电系统,类似于人工智能训练机架架构。
- 机架式 BMC 主板: 机架级计算、存储、网络、冷却管理。
- 环境传感器板: 温度、湿度、振动、入侵监测。
8. 质量、AVL 资质认证和长期项目支持
高性能计算项目的特点是周期长、风险高。一旦Top500系统投入运行,电路板故障就会直接导致科研活动中断——而且客户可能需要在最初采购后的7到10年内才需要备件。
高性能计算质量流程要求
- IPC 3级验收: 高性能计算系统中计算和互连板的标准。
- 显微切片取样: 首件 100%,过程抽样频率高(关键产品通常每个面板抽取 1 个)。
- S参数检验: 在高速电路板上,40 GHz 频率下,优惠券级插入损耗和回波损耗。
- 热循环验证: 按照IPC-TM-650方法进行试样级可靠性测试。
- 每批货物的单据: CoC、工厂证书、电气测试、阻抗、S参数、AOI、显微切片、目视检查记录。
AVL 认证适用于高性能计算 OEM 厂商
- 资格预审审核: 客户质量团队现场考察;审查设备、流程和文件。
- 第一篇文章资格: 提供 25-200 件样品搭建方案及完整文档。
- 工艺验证: SPC 数据证明过程能力;控制计划和 FMEA 文件。
- 客户方验收: 环境测试、系统级验证、正式验收。
- AVL维护: 持续的绩效指标、定期审计、联合质量审查。
长期项目支持
- 备件库存: 在初始部署后 7-10 年内,承诺提供备件生产能力。
- 材料生命周期监测: 我们跟踪层压板和组件 PCN,以便及早发现长生命周期风险。
- 有据可查的替代性: 对于每种合格材料,均需提供近似等效替代品的证明文件。
- 报废管理: 在产品生命周期结束前 18-24 个月,客户和供应商共同制定最后一次采购计划。
- 档案保存期限: 所有设计文件、过程记录和质量数据均保留至项目周期结束+7年。
9. 在高性能计算集群构建中使用 Highleap
对于正在评估 PCB 制造合作伙伴的高性能计算 OEM 厂商、系统集成商和国家实验室硬件合作伙伴而言,我们的合作模式能够适应高性能计算采购中常见的漫长周期和严格的资质认证流程:
- RFP前技术咨询: 应客户工程团队的要求,我们提供支持 RFP 回复的堆叠建议、材料指导和能力说明。
- 提案支持: 正式提案,包含详细的定价、交货时间、产能承诺和符合客户 RFP 要求的质量文件。
- 原型和验证构建: 提供 25-200 件样品,并附有完整的文档以支持客户验收测试。
- 产品发布: 容量预留与系统交付计划保持一致;协调变更控制流程。
- 后勤保障: 备件生产和报废管理贯穿整个系统运行周期。
Highleap 已通过 ISO 9001 和 IATF 16949 认证,并可为需要国防和航空航天级质量文档的高性能计算 (HPC) 项目提供符合 AS9100D 标准的流程。我们生产 8 层至 32 层以上的 HPC 服务器 PCB,采用 HDI 顺序层压工艺,阻抗控制精度达 ±5%,铜厚达 4 盎司,并具备全面的表面处理能力。我们的高速数字生产线采用25 µm 分辨率的激光直接成像技术和HDI PCB 制造工艺,可满足配备 HBM 的 CPU 和 Grace Hopper 载板周围所需的密集 BGA 扇出要求。我们的客户涵盖 HPC 系统集成商、国家实验室硬件合作伙伴以及多代 Top500 项目的大学超级计算中心。
请通过我们的在线报价平台提交 Gerber 文件、钻孔数据、叠层规格、目标数量和项目时间表,我们将在 24 小时内回复。如需 RFP 支持、正式提案制定或现有 HPC 项目的维护计划,我们的 HPC 团队可直接与您联系,讨论范围和时间表。有关相关能力的信息,请参阅我们关于服务器 PCB 制造和刚性 PCB 能力的页面,其中涵盖了 HPC 主板项目的层数、铜箔重量和表面处理覆盖范围。

推荐文章

Taconic RF 35 与 RO4350B PCB 对比
目录 RF-35 与 RO4350B 采购和...

TMM4 滤波器 PCB 制造
TMM4滤波器PCB的生产由……控制。

TMM6 PCB制造
TMM6 制造是中深度工艺控制页面……

TMM3 PCB 射频模块制造
TMM3 PCB制造在射频模块应用中最为常见……
如何获取 PCB 报价
我们将为您进行 DFM/DFA 分析,并向您提供报告。您可以通过我们的网站安全地上传文件。我们需要以下信息才能为您提供报价:
-
- Gerber、ODB++ 或 .pcb,规格。
- 如果需要组装,请提供 BOM 清单
- 数量
- 转弯时间
如需 PCBA 服务,请提供您的 BOM(物料清单)和任何具体的装配说明。我们还提供 DFM/DFA 分析,以优化您的设计,提高可制造性和装配性,确保生产流程顺畅。